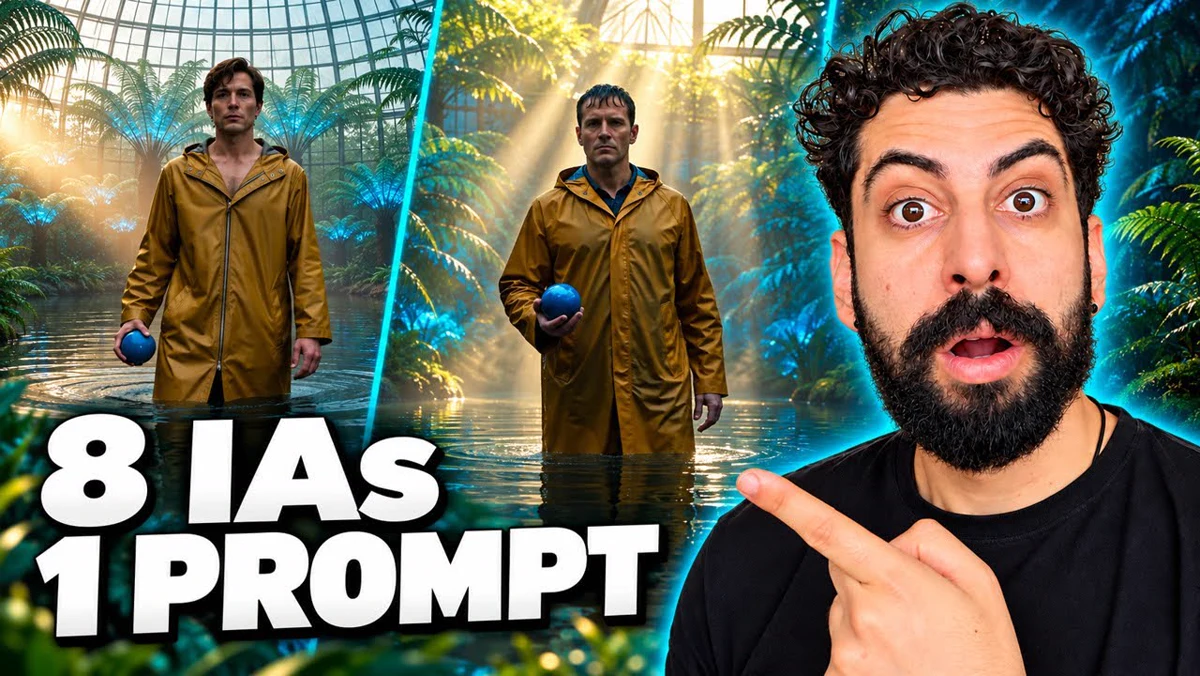
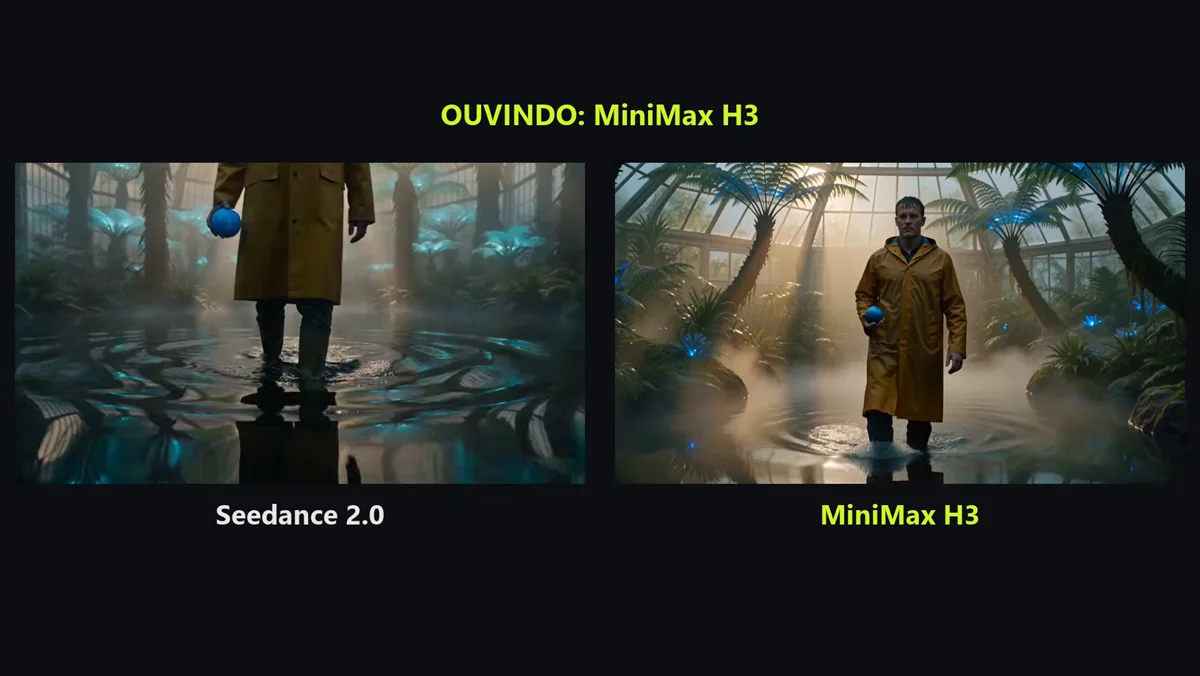
Oito modelos de geração de vídeo por IA foram colocados diante do mesmo desafio: criar uma tomada contínua e fotorrealista de um explorador em uma estufa iluminada, caminhando em água rasa e erguendo uma esfera azul. A proposta transforma um teste aparentemente simples em uma comparação prática de coerência visual, movimento de câmera, reflexos e interação entre mãos e objetos.
Um único texto para medir respostas diferentes
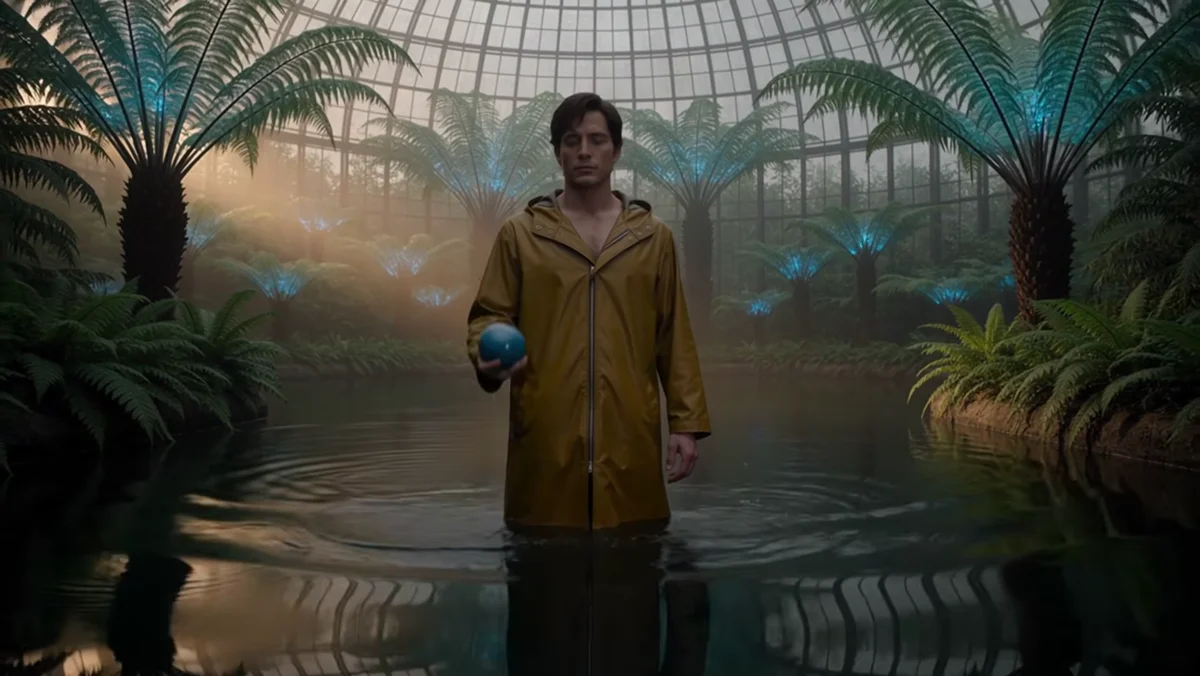
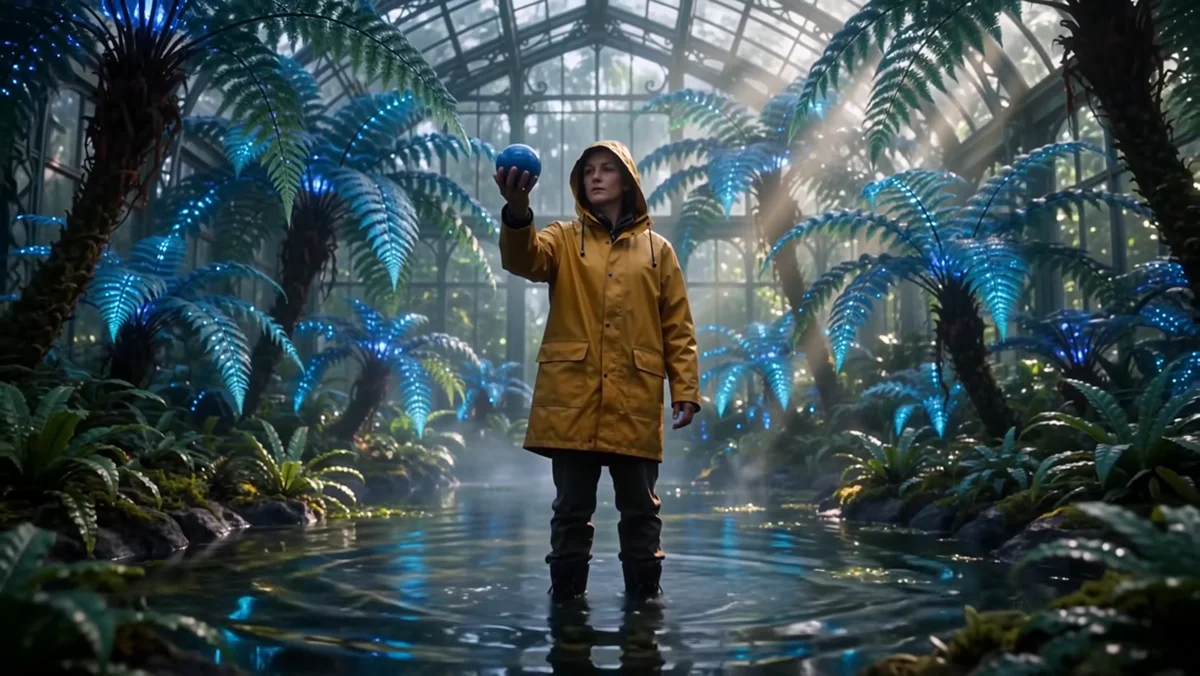
Todos os modelos rodaram no Higgsfield com o mesmo prompt, sem imagem de referência e sem uma rodada extra para aprimorar o resultado. A cena pede três passos lentos, névoa, plantas bioluminescentes, água refletiva, câmera recuando sem cortes e som ambiente sincronizado. Reunir tantos elementos na mesma tomada é uma forma direta de observar onde cada sistema mantém ou perde a consistência.
O que torna o teste exigente
A comparação não depende só de aparência. A mão precisa continuar segurando a esfera, o personagem deve avançar pela água, os reflexos precisam acompanhar o movimento e a câmera deve permanecer fluida. Esses detalhes revelam como a IA lida com continuidade de cena quando vários elementos físicos e sonoros precisam funcionar ao mesmo tempo.
Modelos, formatos e condições iguais
Foram incluídos Kling 4.0, Seedance 2.5, Seedance 2.0, MiniMax H3, Wan 3.0, Grok Imagine 1.5, FLUX 3 e Gemini Omni Flash 1.1. A meta original foi gerar cinco segundos em 16:9 e 720p. Houve diferenças de disponibilidade: MiniMax ofereceu 2K, FLUX entregou 704 pixels de altura, Wan saiu a 30 quadros por segundo e os demais a 24. O áudio permaneceu ativo e cada resultado corresponde à primeira geração concluída.
Comparar é mais útil do que buscar uma resposta única
Ao colocar os resultados lado a lado, ficam mais claras as diferenças no comportamento da água, das mãos e da câmera. Não existe um modelo que responda da mesma forma a toda ideia: o desempenho muda conforme a cena, o movimento e as restrições do pedido. Por isso, a conclusão mais útil é tratar o comparativo como ponto de partida e repetir o teste com o próprio prompt antes de definir uma ferramenta para produção.
O experimento mostra que a evolução da geração de vídeo amplia as possibilidades para cinemáticas, protótipos e estudos visuais, mas também reforça a necessidade de avaliar consistência e controle em cada caso.
Fonte: Neriverso