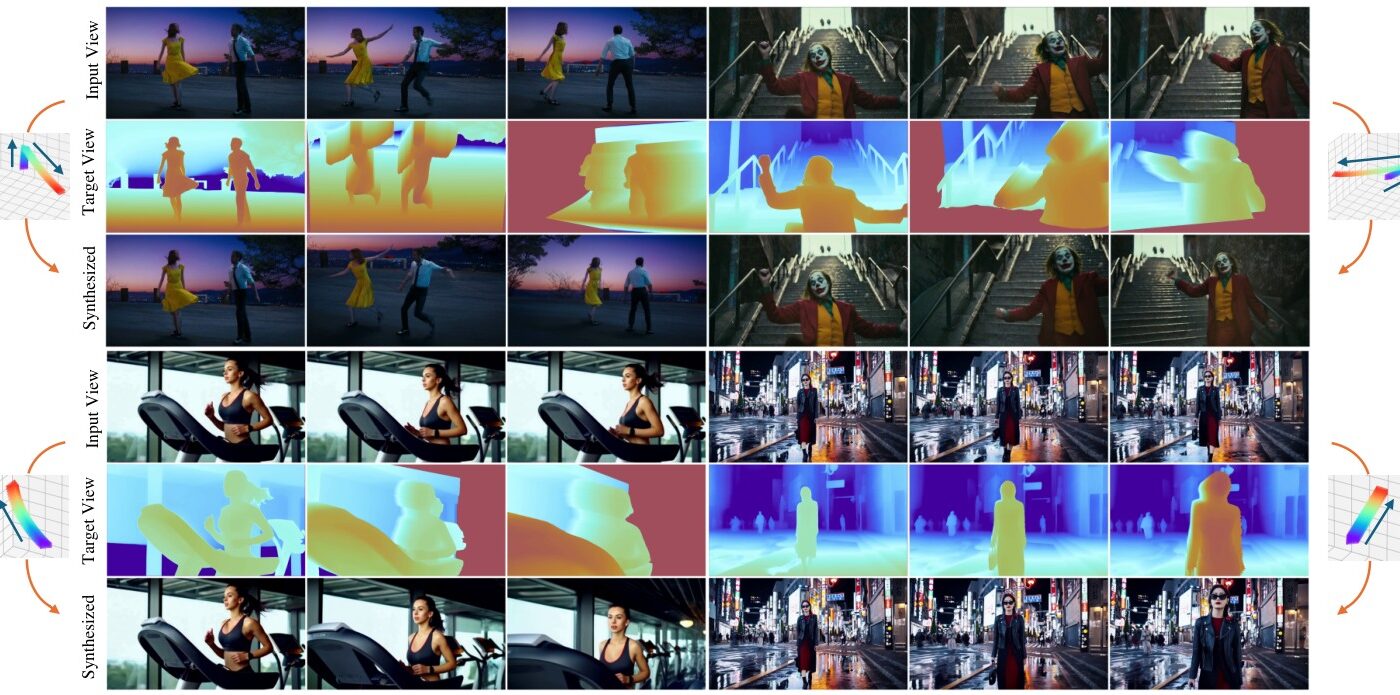
O que aconteceu DepthDirector é uma nova framework de re-rendering de vídeo que permite alterar trajetórias de câmera em um vídeo de entrada mantendo a cena consistente. Funciona como controle preciso de câmera para modelos de geração de vídeo condicionada (VDMs — modelos que geram vídeos por difusão), e foi treinado usando um adaptador leve baseado em LoRA.
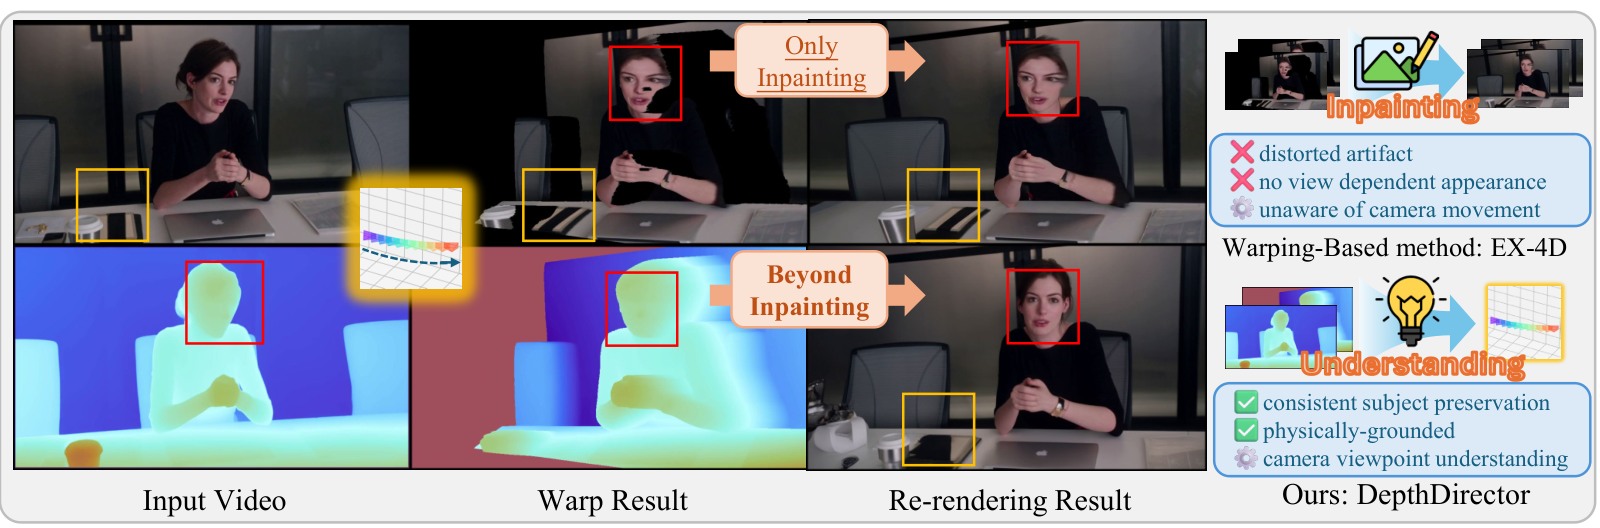
Por que isso importa para você Se você trabalha com produção de cenas 3D, VFX ou prototipagem rápida de cinematics, a promessa é conseguir mover a câmera em um vídeo já existente sem quebrar a aparência dos sujeitos ou introduzir inconsistências — o problema que os autores chamam de "Inpainting Trap", quando métodos de recorte/colagem quebram a continuidade da cena.
DepthDirector injeta vídeo fonte e uma sequência de profundidade renderizada para reproduzir cenas dinâmicas sob novas trajetórias de câmera.
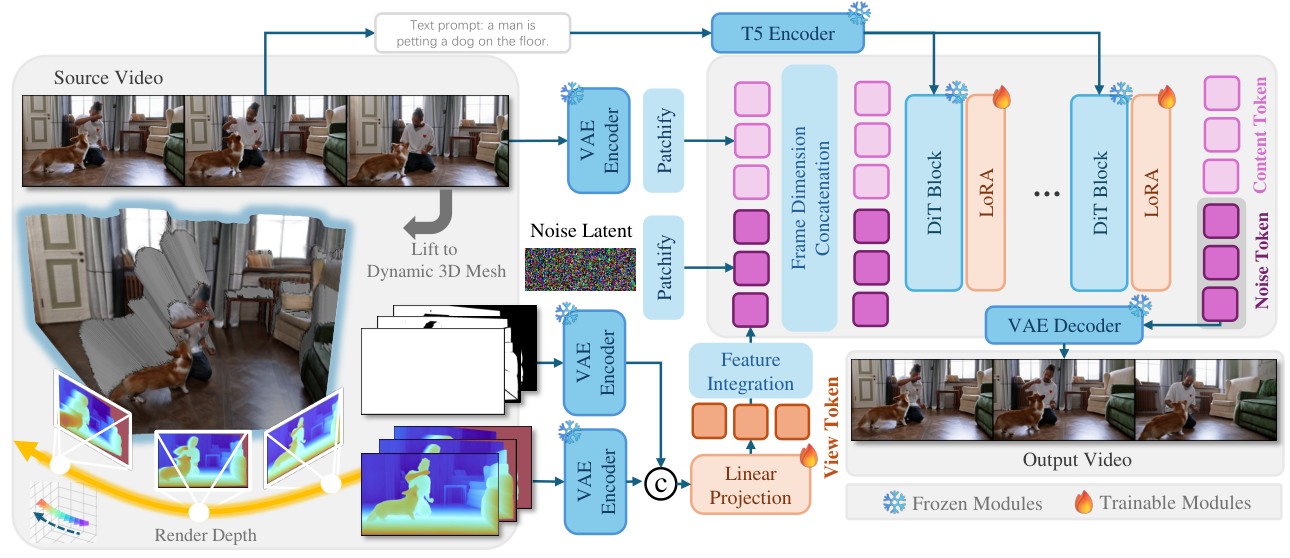
Como funciona, explicado – Profundidade como guia: o sistema usa um "depth video" (sequência de mapas de profundidade) renderizada de uma representação 3D explícita sob a nova vista como sinal geométrico de controle. Isso dá ao modelo noção clara de onde a cena está no espaço. – View-Content Dual-Stream Condition: o método injeta duas entradas no VDM: o próprio vídeo fonte e a sequência de profundidade deformada para a nova câmera. Essa dupla condição ajuda o gerador a entender tanto o conteúdo quanto a nova pose da câmera. – LoRA-based adapter: em vez de treinar o modelo grande do zero, os autores usam uma adaptação leve (LoRA — técnica para ajustar modelos grandes com poucos parâmetros) para preservar o conhecimento prévio do VDM enquanto o sistema aprende a re-renderizar sob novas câmeras.
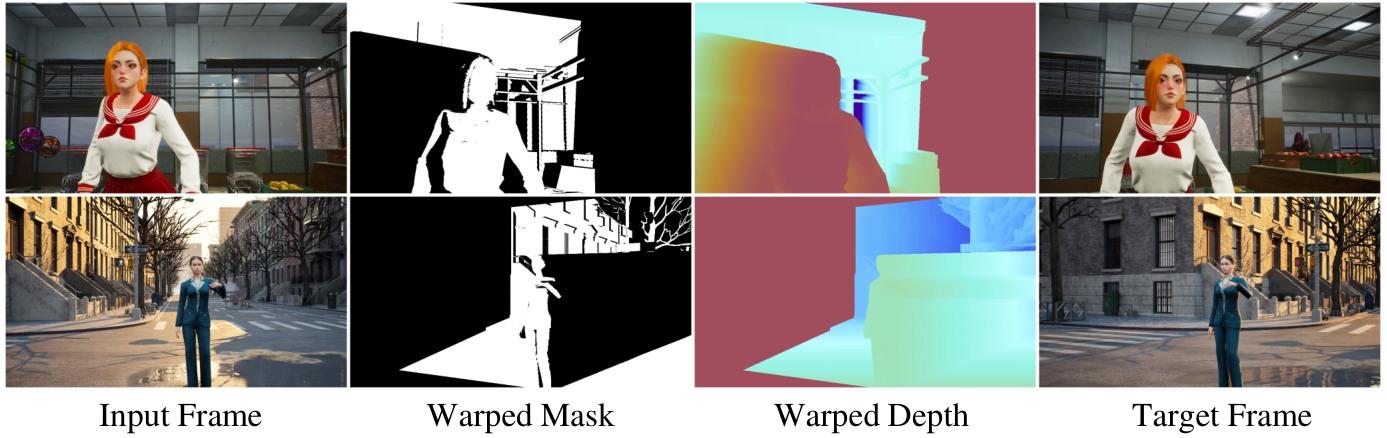
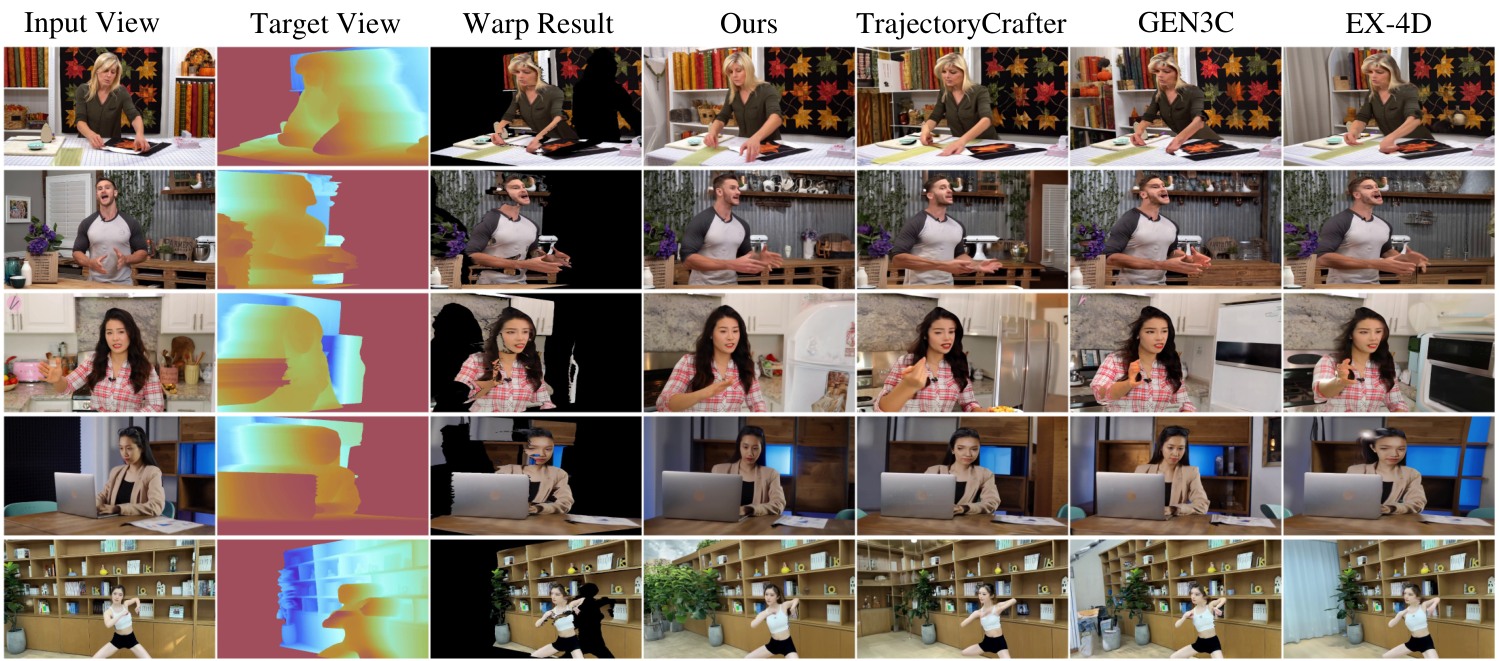
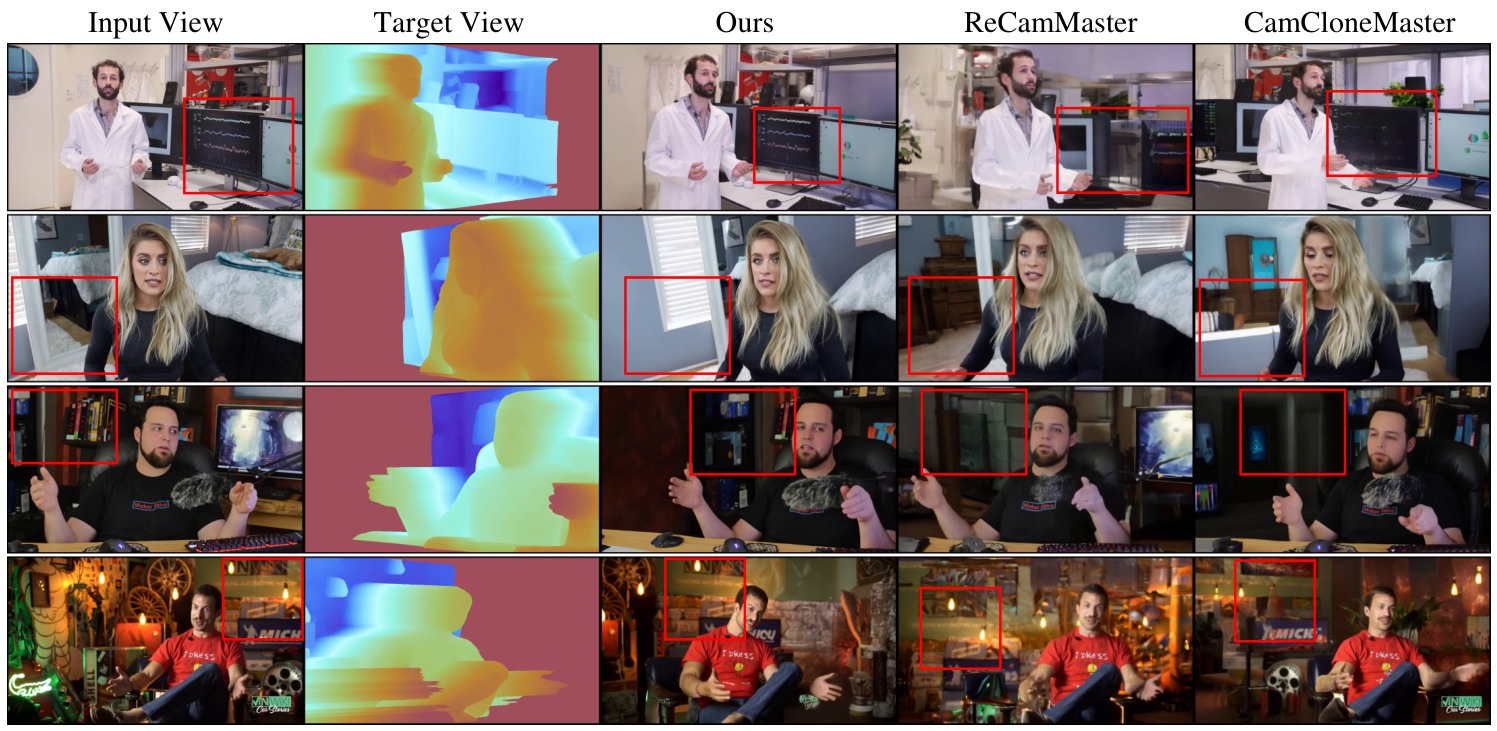
Resultados e recursos fornecidos Os autores relatam que DepthDirector supera abordagens anteriores em controle de câmera e qualidade visual. Eles também construíram o MultiCam-WarpData, um conjunto grande de dados multi-câmera criado com Unreal Engine 5, com 8K vídeos cobrindo 1K cenas dinâmicas. Código e dataset serão disponibilizados publicamente.
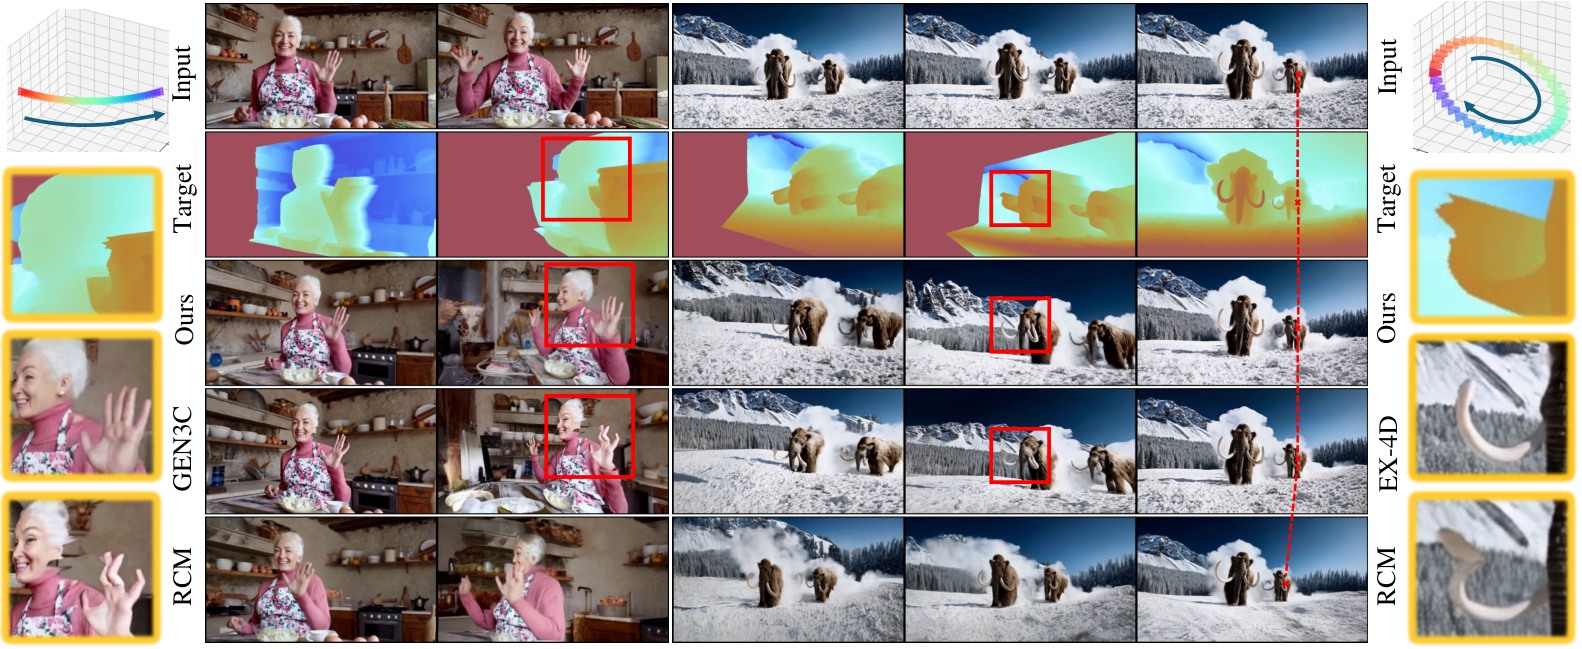
Contexto e o que vem a seguir A ideia central é forçar o modelo de vídeo a usar noção 3D explícita (profundidade) em vez de confiar só em inpainting, que tende a quebrar consistência quando a câmera se move. Na prática, isso abre espaço para fluxos de trabalho onde você testa novas composições de câmera em cenas gravadas ou sintéticas sem reconstruir tudo do zero. O passo lógico agora é testar o método em material real de produção e ver como ele lida com detalhes finos de iluminação e oclusões — e acompanhar a liberação do código e do dataset pelos autores.
Veja também no Neriverso
Fonte: arXiv cs.GR